OpenAIは10月26日、GPT-6.1 Terraをリリースした。PCを操作するエージェント向けに設計されたモデルで、画面の内容を理解し、アプリケーション内で操作を行い、文章の作成やプログラミングをこなす。APIの料金はOpenAI公式発表によると入力100万トークンあたり1ドル、出力5ドルで、GPT-6.1 Solの半額となる。ChatGPTではWorkおよびCodexプランで利用可能だ。オフィス自動化の基本コストを下げる意味で注目されるが、トークン単価と「業務を完遂するためのコスト」は別の数字であり、公表されたベンチマーク結果はすべてOpenAI自身によるテストに基づく点は押さえておきたい。
本稿はOpenAIの公式発表と2026年10月26日付のChatGPTリリースノートを参照している。OpenAIのXへの投稿はInteresting Engineeringの引用を通じて参照した。OpenAI for StartupsのLinkedIn投稿および公式APIの料金ページは直接確認できなかったため、他モデルの価格は各メディアの報道を引用元として明示する。
GPT-6.1 Terraは何ができるのか
OpenAIは「高速かつ効率的」なモデルと位置づけ、視覚的推論、コンピューター操作、より明確な文章生成を組み合わせた設計としている。発表で挙げられたユースケースは具体的なオフィス業務だ。提案書の作成、技術図面の読み取り、フォームへの入力、動画編集、請求書データの会計ソフトへの自動入力などが含まれる。GPT-6ファミリーの中では「高速・低コスト」に位置づけられ、GPT-6 Astraが最高性能、GPT-6.1 Solが中間モデルとなる。OpenAI自身も、複雑なプログラミングタスクにはSolまたはAstraが適切と明記している。
前世代の同クラスモデルGPT-5.6 Terraとの比較が今回の主な訴求点だ。APIではモデル名「gpt-6.1-terra」として即日利用可能となっている。ChatGPTでは、発表によれば同じ使用枠でGPT-5.6 Terraより多くのタスクをこなせるとされ、SolやAstraと比べればさらに差が広がるとのことだ。
他モデルとの価格比較
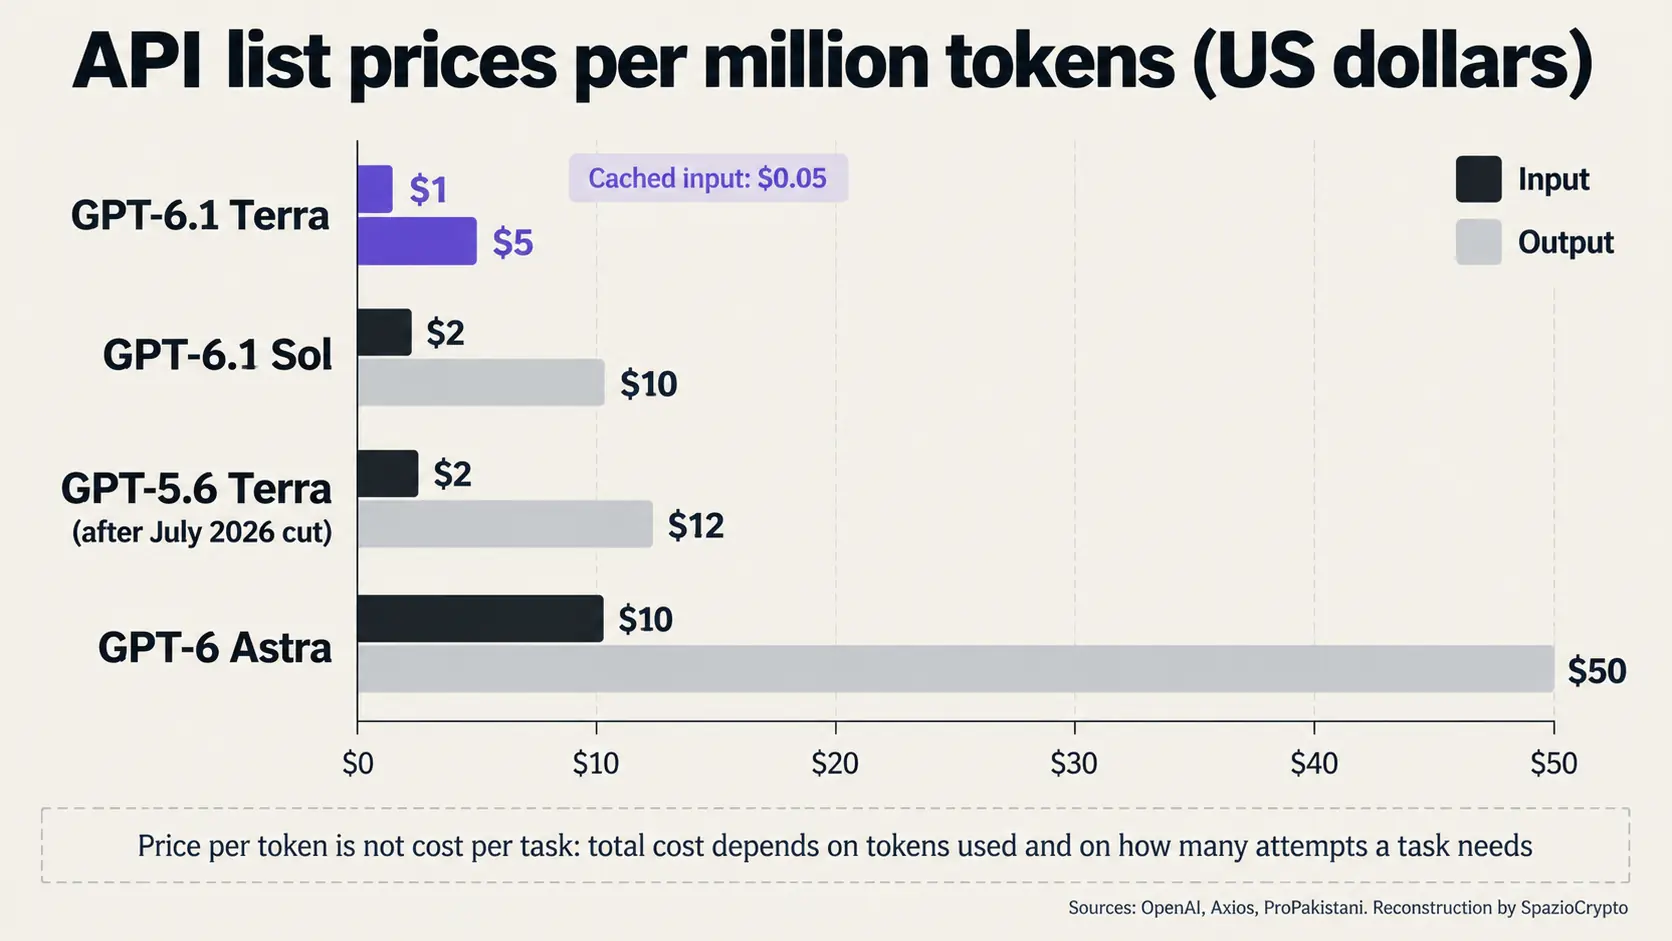
発表されたAPIの料金はOpenAI公式情報によると、入力100万トークンあたり1ドル、キャッシュ済み入力0.05ドル、出力5ドルだ。OpenAIはGPT-5.6 TerraおよびGPT-6.1 Solより50%安いとしている。ProPakistaniの報道によれば、Solの価格は入力2ドル・出力10ドルであり、確かに半額となる。一方、Axiosが伝えた7月値下げ後のGPT-5.6 Terra価格は入力2ドル・出力12ドルで、出力単価は今回58%下がった計算になる(編集部試算)。GPT-6 Astraは同じくProPakistaniによると入力10ドル・出力50ドルと、Terraの10倍の価格帯だ。
キャッシュ済み入力の価格は見かけ以上に重要だ。コンピューターを操作するエージェントは同じ指示や同じコンテキストを繰り返し参照することが多く、その部分は通常価格のごく一部で済む。これはAI インフラ整備の世界的な競争によるコスト上昇とは逆の方向性だ。インフラ構築コストは上がり続けているにもかかわらず、クラウドプロバイダーは顧客向け価格を下げる競争を繰り広げている。
トークン単価とエージェントコストはなぜ異なるのか
むしろトークン単価はタクシーのキロ単価に似ている。道のりの値段は示しても、目的地までの総額は別の話だ。最終的なコストは、エージェントが画面操作・推論・応答で消費するトークン数と、最初の試みが失敗して再実行が必要になる回数によって決まる。そこでOpenAIはタスクあたりのコストも測定している。プロフェッショナルなコンピューター業務を想定したAgents' Last Examでは、中程度の処理負荷でTerraがGPT-5.6 Terraを15ポイント上回り、コストは約3分の1に抑えられた。最大処理負荷ではOpenAIの発表によると、Claude Opus 5.5の3分の1以下のトークン消費で、タスクあたりコストは約9分の1になるとされる。
具体的な数字で考えてみよう。あくまで編集部の試算だが、入力20万トークン・出力2万トークンを消費するタスクを想定する。Terraでは約0.30ドル、Solでは0.60ドル、Astraでは3ドルとなる計算だ。ただし、Terraが一発で成功する確率が50%にとどまる場合、タスク完遂あたりの平均コストは0.60ドルに跳ね上がり、Solと同等になる。低い単価が本当に意味を持つのは、エージェントが確実に業務を完結できる場合に限られる。
OpenAIのテストはどこまで信頼できるか
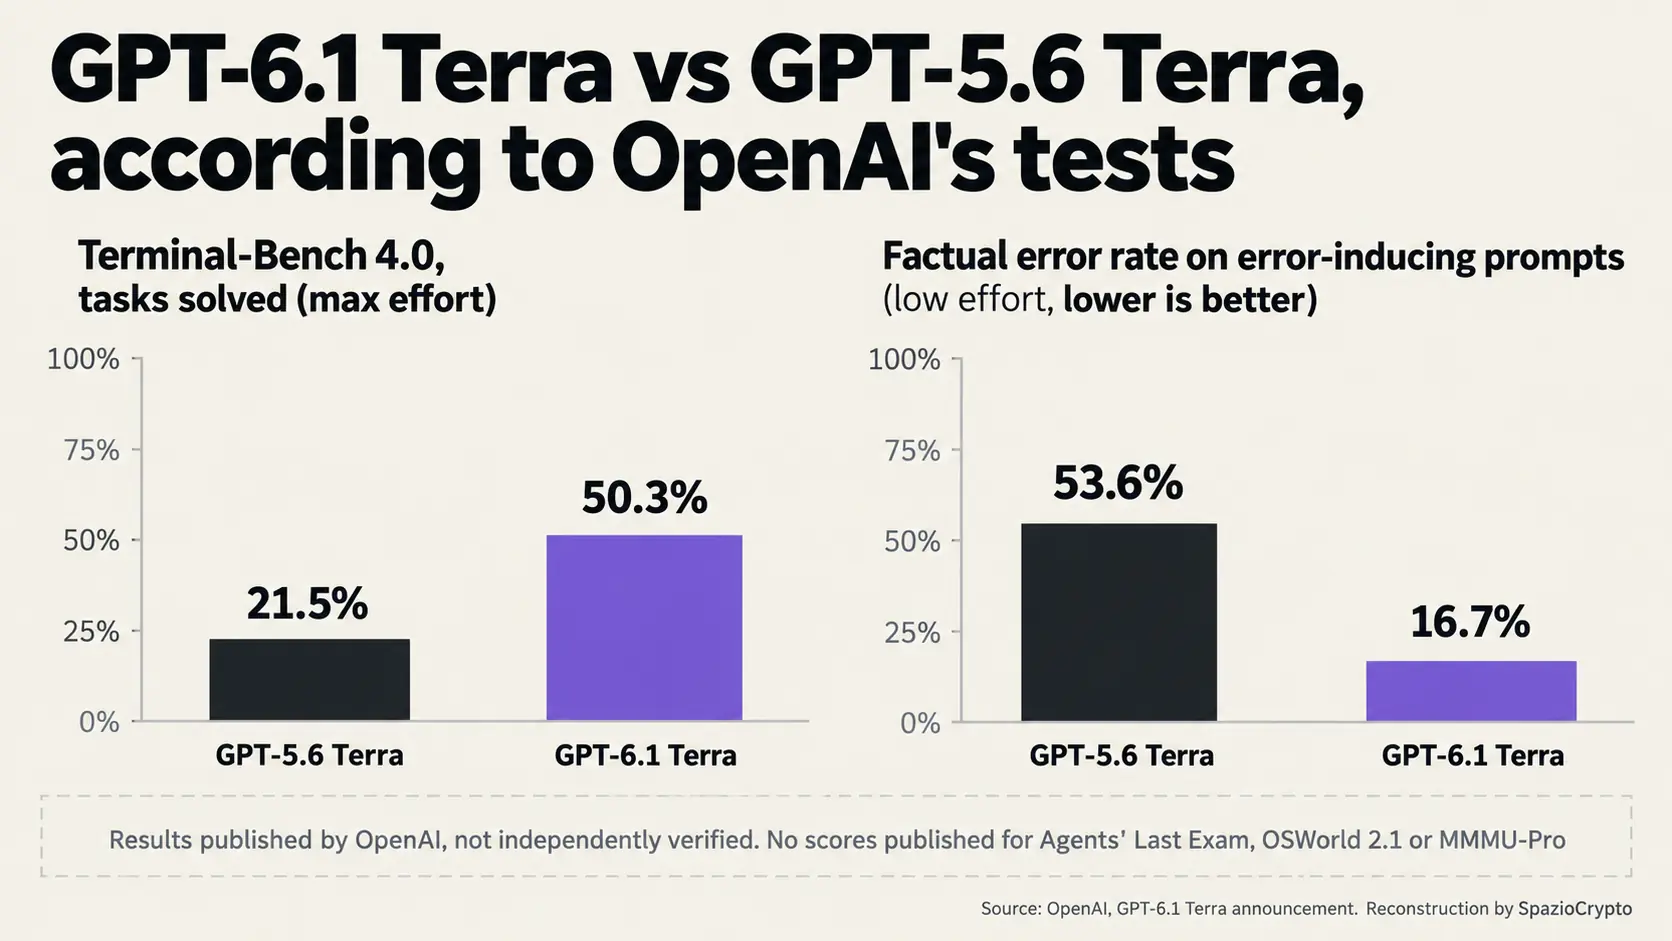
公表されているベンチマーク数値はすべてOpenAI自身によるものだ。コマンドライン操作のプログラミングを測るTerminal-Bench 4.0では、最大処理負荷でTerraが50.3%のタスクを解決し、GPT-5.6 Terraの21.5%を大きく上回った。事実誤認を誘発するよう設計した社内テストでは、低負荷時のエラー率が53.6%から16.7%に低下し、最大負荷では4.3%まで下がり、前モデルから18ポイントの改善となった。OSWorld 2.1(デスクトップアプリ操作)とMMPU-Pro(視覚的推論)については、OpenAIは改善があったと発表しているが、具体的なスコアは公式発表に含まれていない。
独立した検証や実際の業務における実績データはまだ存在しない。企業における真のエージェントコストを左右するのは、まさにそうした実務データだ。ベンチマークはテストコースを計測するにすぎず、実際のオフィスで日々発生するプログラム、パスワード、例外処理といった現実の業務トラフィックを反映するものではない。
利用できるのは誰か、そしていつから?
実際には、APIでは発表日から即日利用可能となっている。ChatGPTについてはOpenAI内部の情報源が完全には一致していない。発表ではPlus、Pro、Enterprise、Eduユーザー向けに「本日より」提供開始と記載されているが、リリースノートではBusinessも対象に加えられ、展開はプラン、地域、ワークスペースの設定によって異なると明記されている。各プランの利用上限は変更なし。一部のPlusおよびProユーザーはWorkのデフォルト設定で利用できる場合があるが、アラブ首長国連邦での処理データ居住には対応していない。
企業としてまず取るべき行動は、プロジェクトを計画する前に自社アカウントでのアクセス可否を確認することだ。自動化への圧力は現実にある。銀行や保険会社はすでに人工知能への投資を進めており、既存アプリケーション上で動作するモデルは統合作業を大幅に削減できる。
エージェントがコンピュータを操作する際に残るリスクとは
むしろクリックやフォーム入力を行うエージェントは、単なる提案にとどまらず実際に行動する。OpenAIは、GPT-6.1 TerraがPreparedness Frameworkのサイバーセキュリティ基準における「Critical」しきい値に達し、GPT-6 Astra向けに開発された保護機能を継承していると公表している。同社によれば、ページ内に埋め込まれた隠し指示でタスクから逸脱させようとするプロンプトインジェクション攻撃への耐性も向上したという。OpenAI社内テストでは、前モデルと比べて与えられた制約内にとどまり、自身のブロック状態を開示する傾向が強まったとされているが、これらはあくまで自己申告による保証であり、第三者による検証は行われていない。
運用上のリスクはモデル単体では解消しないというのが本稿の見解だ。エージェントに付与する権限、資金やデータを動かす操作への人間によるレビュー、そして各ベンダーの利用規約が重要になる。Claudeのエージェント向け利用ポリシー改定が示すように、規約は現在進行形で更新されている。欧州の企業には依存リスクという別の問題もある。監督当局はすでに、EU金融セクターが海外AIモデルに依存している実態を指摘している。
GPT-6.1 Terra 概要
確認済みの事項と未確認の事項
- 確認済み: 10月26日にAPIへ gpt-6.1-terra として公開。入力100万トークンあたり1ドル、キャッシュ0.05ドル、出力5ドルの価格。ChatGPT WorkおよびCodexへの展開が進行中。各プランの利用上限は変更なし。
- 未公開: Agents' Last Exam、OSWorld 2.1、MMMU-Proの絶対スコア。実業務におけるパフォーマンス。プランおよび地域ごとの展開スケジュール。第三者検証の結果。
- 今後の注目点: コンピュータ操作に関する独立テスト、初期の企業プロジェクトにおけるタスクあたりの実コスト、競合他社の価格対応。
より大きな文脈で読む
モデル間の競争が処理能力からタスクあたりのコストへとシフトしつつあるというのが本稿の見立てだ。低コストかつ信頼性の高いエージェントは、これまでコスト面で見合わなかった自動化を持続可能にする。それはソフトウェアや機械が自律的にタスクをこなしサービス料を支払う、TetherがUSDTで描くマシンエコノミーの構想にも近づく動きだ。ただし価格低下の裏側には計算処理の物理的コストがある。エージェントに委ねるタスクが増えるほど、すでにエネルギー消費が記録的水準に向かっているデータセンターの負荷はさらに高まる。
注視すべきシグナルは三つある。第一は、OpenAIの自社ラボ外でも宣言されたアドバンテージが通用するかを検証する、コンピュータ操作に関する独立テスト。第二は、エラー、リトライ、人間による監督が絡む初期の企業プロジェクトで明らかになるタスクあたりの実コスト。第三は競合他社の対応だ。この規模の値下げは市場全体を動かす傾向がある。