AIプロバイダーが特定のモデルを使用していると主張するとき、ユーザーはどうやってそれを確認できるのか。2026年11月2日。AnthropicはFlashProveをオープンソースの試作品として公開した。FlashProveは、モデルの重みを開示することなく、特定のAIモデルが応答を生成したことを暗号証明によって示す仕組みだ。実証は4ビット変換版のLlama 4 Maverick、1,024トークンのウィンドウで行われた。Claude APIでの提供は行われておらず、コードは非メンテナンス状態であることが明記されている。
本稿はAnthropicの研究投稿(EPFL・MITの研究者との共著)およびGitHubの公開リポジトリのREADMEを参照している。2026年11月3日にAnthropicがXに投稿したポスト経由でも告知されたが、一部ツールでは開けない場合がある。以下に引用するパフォーマンスデータはAnthropicの自己申告値であり、第三者による検証は行われていない。
New Anthropic research: progress on provable inference for large language models.
,Anthropic (@AnthropicAI) November 3, 2026
Here, we introduce FlashProve. Building on established cryptographic techniques, FlashProve allows developers to verify whether a given response came from a given AI model. It's substantially more…
課題:実際にどのモデルが応答したのか
言い換えると、Anthropicによると、現状のユーザーは、開発者が宣言するモデルから応答が届いているかどうかを確認する手段を持たない。同社の研究投稿は二つのリスクを指摘する。一つ目は、約束されたモデルをより安価なモデルに差し替えるルーティングサービスの存在だ。二つ目は、モデルとユーザーの間のトークンストリームを改ざんする攻撃である。中間プラットフォームを通じてAIを購入するユーザーにとって、これは抽象的な話ではない。料金を払ったモデルが実際に動いているかどうか、確かめる方法がない。
この問題は、AIモデルの流通チャネルが多様化するにつれて深刻さを増している。サードパーティのモデルを再販するクラウドサービス(たとえばOpenAIがGoogle Cloudに参入した例)から、複数プロバイダーが異なる価格で提供するオープンウェイトモデル(MiniMaxのFlashバージョンなど)まで、ユーザーが実際に何を使っているかを把握しにくい状況が広がっている。
仕組み:コミット・証明・検証の三段階
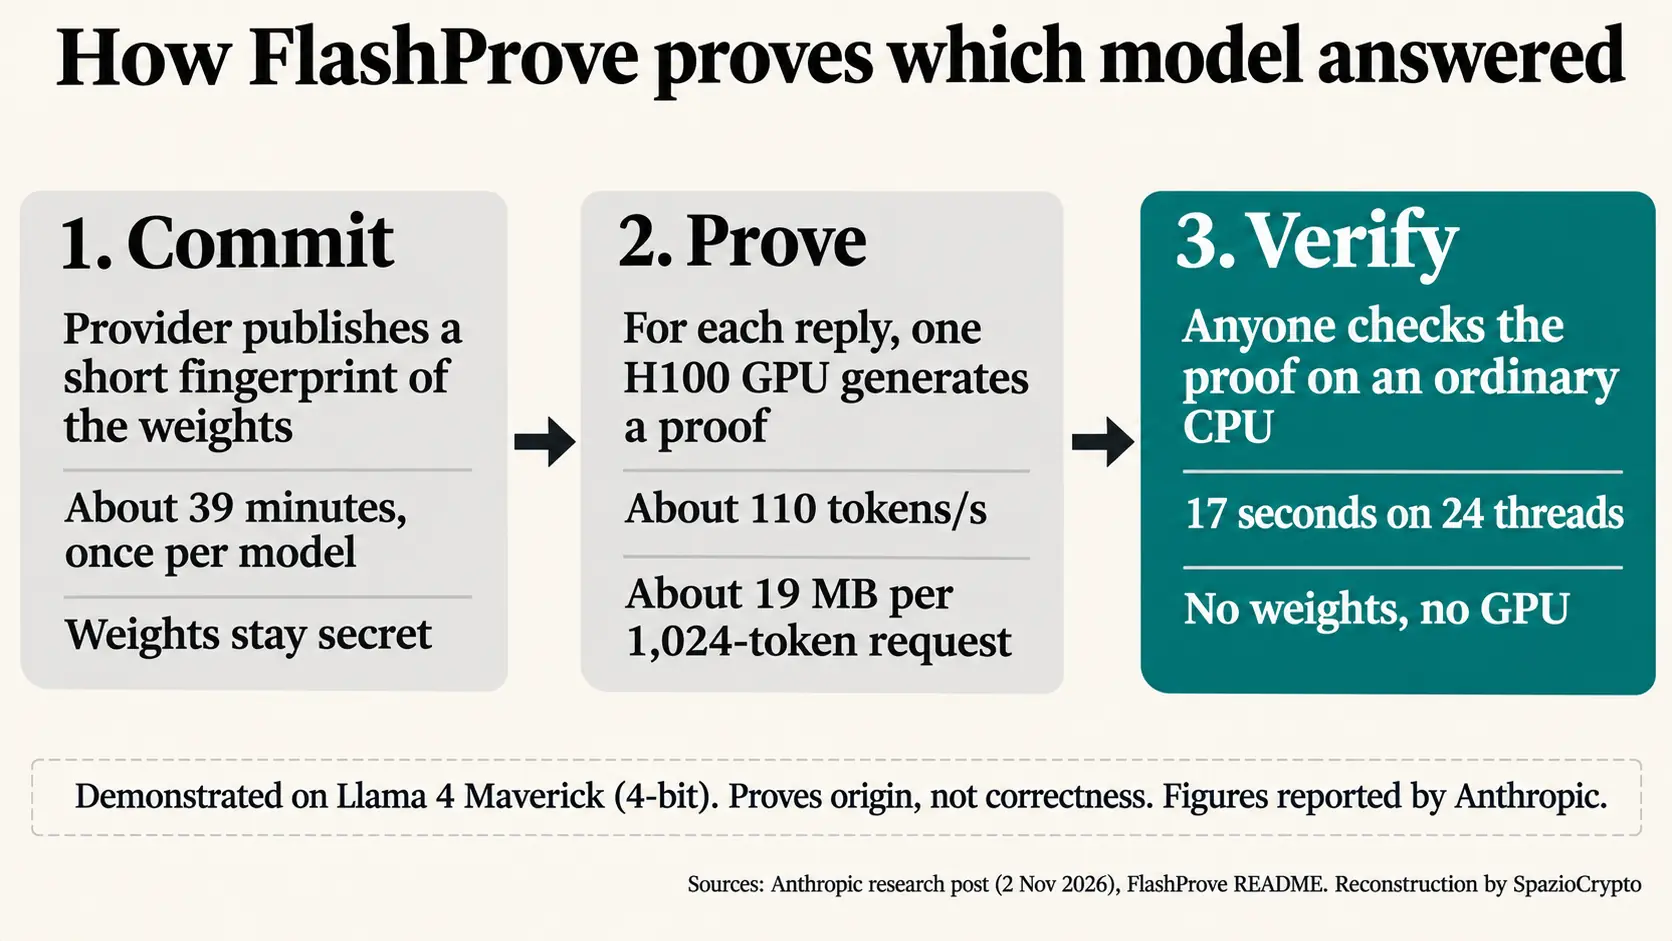
FlashProveは三つのステップで動作する。まずプロバイダーが、モデルの重みを公開せずに特定の重みセットに自らをバインドする短い「フィンガープリント」を公開する。Anthropicによると、この段階はモデルごとに約39分かかる、一度だけの処理だ。次に、各応答に対してプロバイダーのGPUが、そのトークン列がコミット済みモデルの出力であることを示す証明を生成する。最後に、重みもGPUも不要な通常のプロセッサで、フィンガープリント・プロンプト・応答だけを使い、誰でもその証明を検証できる。
採用されている技術はzkSNARK(ゼロ知識簡潔非対話型知識論証)だ。計算が正しく実行されたことを、使用したデータを明かさずに証明するゼロ知識証明の一種である。これはクリプト業界がプライバシーとスケーラビリティのために用いてきた手法と同じ系譜に属する。モデルの重み、中間値、エキスパートの選択は秘匿されるが、Anthropicはアーキテクチャ自体は隠さないと明記している。
試作品の数字
言い換えると、Llama 4 Maverickは4,000億パラメータのMixture-of-Expertsアーキテクチャを持ち、トークンごとに約170億パラメータが有効化される。FlashProveの試作品は公開の4ビット変換版で動作する。Anthropicの報告によると、24コアのCPUを搭載したH100 GPU 1基で、証明フェーズは毎秒約110トークンで進み、1,024トークンのリクエストごとに約19メガバイトの証明ファイルが生成される。証明の検証には24スレッドで17秒を要し、クライアントは約6.5メガバイトのコミットメントデータをダウンロードする必要がある。
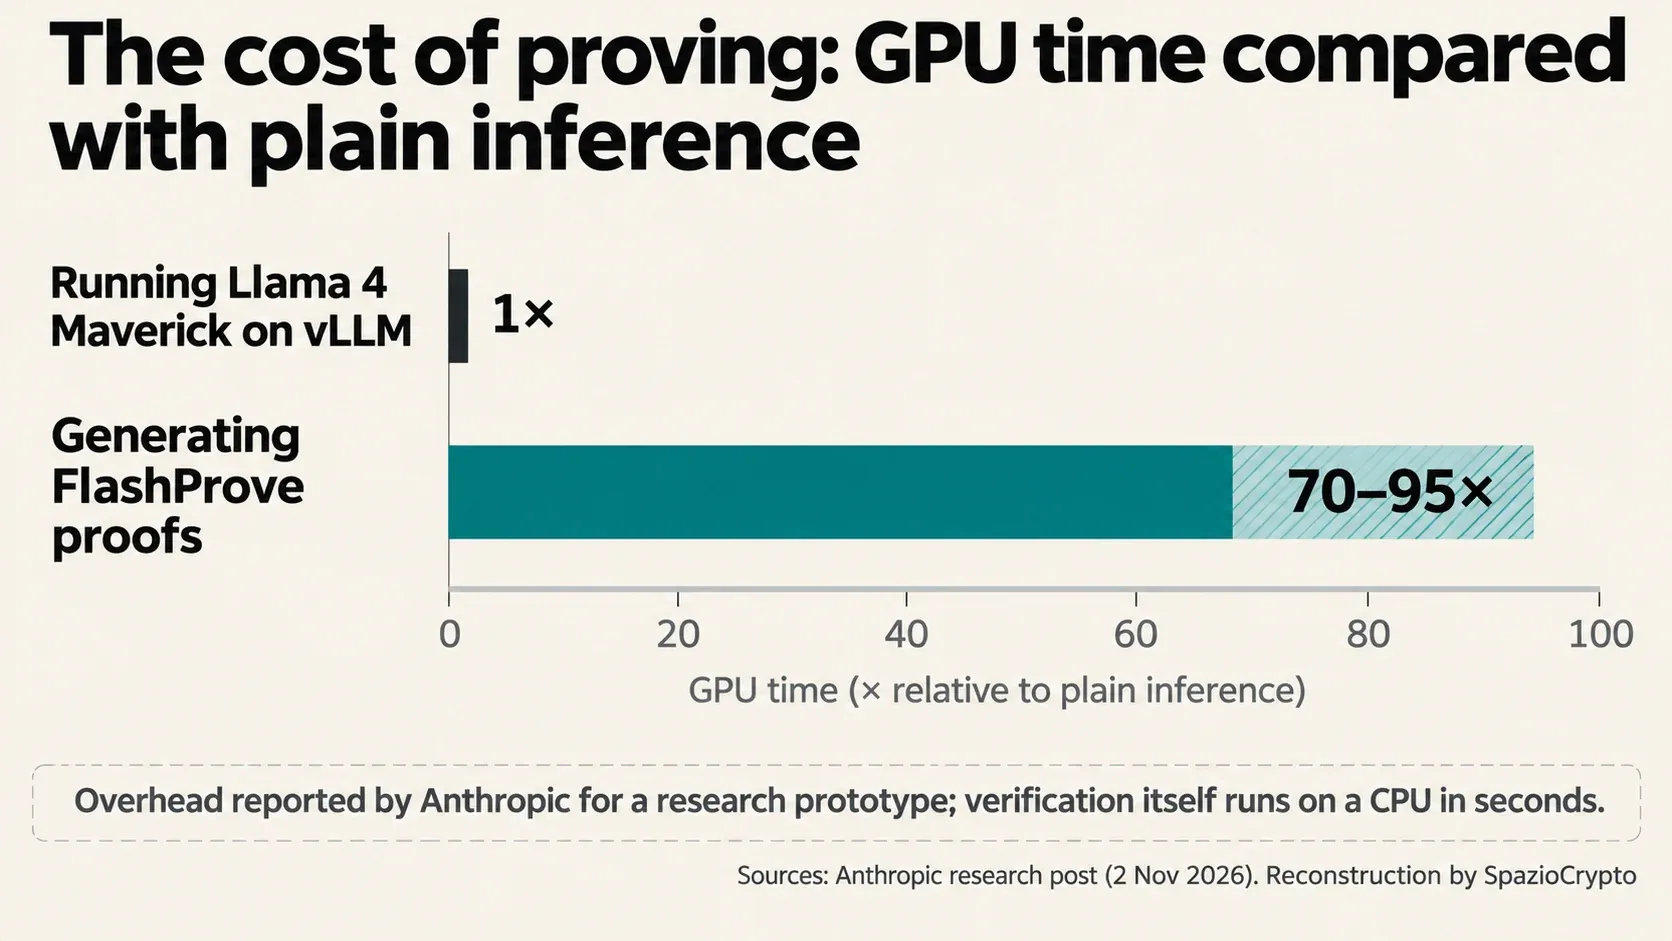
最も重要なコスト指標を見ると、Anthropicの同投稿によれば、証明生成には広く使われる推論エンジンvLLMでモデルを実行する場合の70倍から95倍のGPU時間が必要となる。同社は別の研究であるAttestableと比較しており、Attestableは310億パラメータの密なモデルで毎秒53から77トークンを達成しているが、オープンソースライブラリは公開していない。
証明が保証しないこと
証明が示すのは、ある回答がどのモデルから生成されたかという出所であり、その回答が正しいかどうかではない。Anthropicはほかにも複数の制約を列挙している。証明が対象とするのは決定論的なデコードであり、回答にランダム性を導入するサンプリングを用いた場合、実際の出力はある時点で乖離する可能性がある。証明されるモデルは重みの完全な整数バージョンであり、浮動小数点演算で得られた回答はそこから外れることがある。準同等性は、差異を意図的に利用するよう設計されたプロンプトには対応しておらず、応答時間を利用したタイミング攻撃も対象外だ。
実用上の制約もある。1,024トークンというウィンドウはAnthropicの言葉を借りれば「会話としてはかなり短い」。高速なC++コードには形式的な保証がなく、プロトコルの健全性を数学的に示したLean言語で書かれた証明と厳密に一致するとは限らない。リポジトリのREADMEは明確だ。これはあくまで研究成果物であり、「メンテナンスされず」、外部からのコントリビューションも受け付けないとされている。外部セキュリティ監査についての記載もない。
 Anthropic
日本や企業への示唆
AIサービスをリセラーやプラットフォーム経由で調達している企業や行政機関にとって、FlashProveは今日の時点では何も変えない。製品でもなく、商用サービスに統合されてもいない。ただし方向性は示している。特定モデルを約束する契約が、ベンダーへの信頼ではなく証明によって検証可能になる日が来るかもしれない。ゼロ知識証明が金融サービスで辿った道筋と同じだ。Coinbaseが米国のマネーロンダリング防止規制における承認を求めた事例がその先行例として挙げられる。
 Steve Weis
欧州の技術依存という問題とも関わる。EU金融当局の監視報告によれば、欧州の金融セクターは複数のベンダー層を経由して海外のAIに依存している。コストが下がれば、ベンダーに依存しない検証ツールが契約要件になり得る。ただし現状、GPU推論時間の70倍から95倍というオーバーヘッドでは、日常的な利用の選択肢にはならない。
FlashProveの要点
確認されていること、確認されていないこと
- 確認済み: Apache 2.0ライセンスのオープンソースプロトタイプとして11月2日公開。4ビット量子化のLlama 4 Maverick、1,024トークンのウィンドウで実証済み。重みなしでCPU上17秒で検証可能。通常GPU推論時間の70倍から95倍のコスト。コードはメンテナンスされないと明記。
- 未明示: 外部セキュリティ監査の有無。金銭的コスト。Claude APIや他モデルへの適用。より長いコンテキストでの処理時間。
- 今後の注目点: より長いコンテキストや他のアーキテクチャへの拡張。ベンダーやプラットフォームによる採用の有無。コードの独立した検証。
より大きな視点から読む
これは私たちの見解として明示する。FlashProveがAIにもたらすのは、クリプトの世界で生まれた「信頼せず、検証せよ」という思想だ。現在AIサービスの利用者は、どのモデルが使われているかをベンダーの言葉を信じるしかない。かつて口座残高を仲介者に信じるしかなかったのと同じ構造だ。暗号学的証明は、回答の出所と回答の質という、混同されがちな二つの問いを切り離す。FlashProveが答えるのは前者だけだが、それだけでも意義は大きい。Anthropicを含む誰かが実際のサービスへ展開するかどうかは、たとえばMETRの評価者がAnthropicの内部にアクセスする取り組みのような他の透明性イニシアチブと並んで、今後を見極める必要がある。
注視すべきシグナルは三つある。第一は計算オーバーヘッドの削減で、現状70倍から95倍の水準では、どのプロバイダーも全回答に証明を提供できない。第二は長いコンテキストやClaudeのような非公開重みモデルを含む他モデルへの拡張。第三は、開発者自身が手を引いたこのコードを、検証可能な出所を売りにしたい他のグループやプラットフォームが引き継ぐかどうかだ。