MiniMaxは2026年10月19日、MiniMax M3.1 Flashを公開した。入力トークン100万件あたり0.15ドル、出力トークン100万件あたり0.60ドルという価格設定で、モデル自体はすでに同社のAPIサービス経由で利用可能だ。モデルの重みは後日公開される予定となっている。エージェントやソフトウェアを構築する開発者にとって重要なのは、単価が下がっても実際のタスクコストはシステムの推論量、使用するツール、必要な修正回数によって大きく変わるという点だ。
料金表は2つのレートを半減させるが、全請求を半減させるわけではない
言い換えると、公式の料金ページを参照すると、比較は明確だ。入力512,000トークン以内のスタンダード帯では、MiniMax M3は入力100万トークンあたり0.30ドル、出力100万トークンあたり1.20ドルだった。Flash版はその両方を半減させる。キャッシュ読み取りは100万トークンあたり0.06ドルから0.015ドルに下がる。これらは異なる請求項目であり、キャッシュ価格は送信した全素材ではなく、実際に再利用可能と認識されたトークンにのみ適用される。
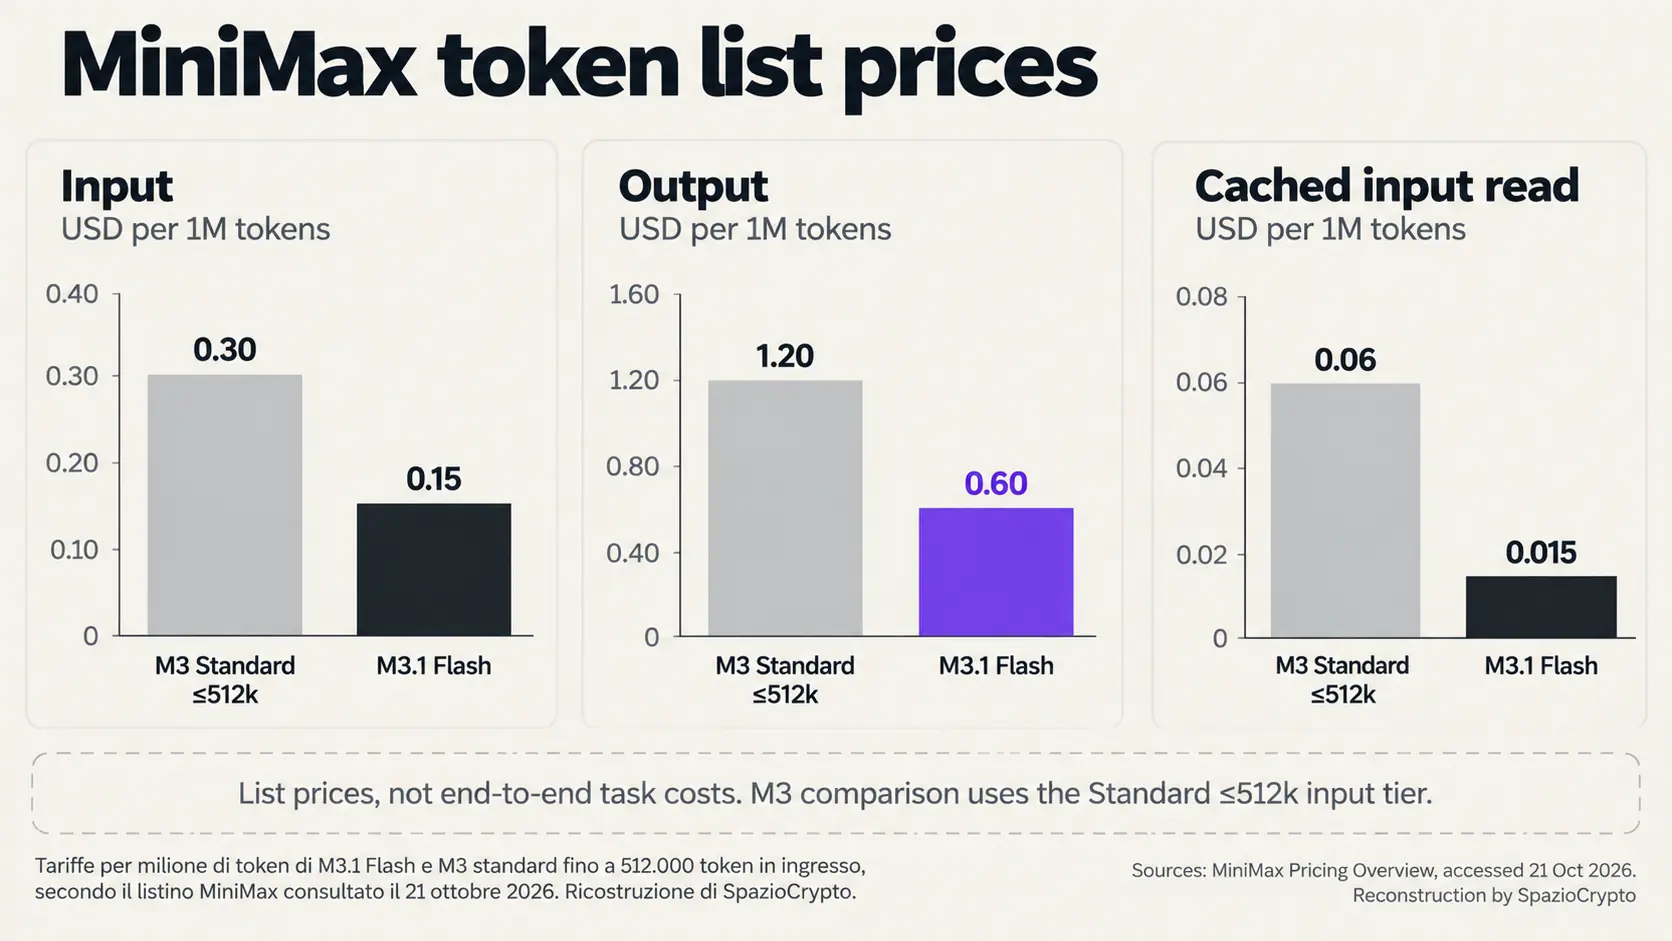
MiniMaxの公式発表によると、エージェント型タスク全体のコストは前モデル比70%削減できるとされている。ただし、この数字は主要な2つの料金が半減するという事実とは一致しない。消費量やタスク完了方式の違いを含む可能性はあるが、全ての顧客に同じ節約を保証できるわけではない。自動化システムの導入を検討する際。この区別は検証可能な料金表と、実際の負荷で測定すべき運用上の結果を切り分けるうえで重要だ。
具体例で差を示そう。入力100万トークン(指定された帯域内に分散)と出力100万トークンの10%、キャッシュなしという仮定では、Flashは0.21ドル、M3は同帯域で0.42ドルとなる。これはSpazioCryptoが同一の想定消費量で試算した参考値であり、追加の外部API呼び出し、ツール使用、人的作業は含まない。エージェントがステップを繰り返したり、より多くの推論を生成したりすれば、単価が変わらなくても請求されるトークン量は増加する。
推論には調整レベルがあり、オフにはできない
Anthropic互換インターフェースのドキュメントには。推論レベルがlowからmaxまでの5段階で定義されている。M3.1 Flashでは。パラメータを省略した場合のデフォルト値はmaxだ。アダプティブな推論は。無効化を意図したパラメータ値を指定しても停止しない。ドキュメントはその要求に対してエラーを返すと明記している。旧来の設定を流用して統合する場合。新モデルが実際にサポートする動作を改めて確認する必要がある。
同ドキュメントによると、推論レベルを上げると推論トークンが増加し、レイテンシも大きくなる可能性がある。つまり、トークン単価と応答全体の所要時間は異なる2つの側面を表している。SpazioCryptoの見解では。有意義なテストを行うには目標、ツール、合否基準を固定したうえで選択したレベルを記録することが不可欠だ。これを怠ると、高速な応答と深い処理を行った応答を、差異の理由を明示せずに比較してしまうリスクがある。
MiniMax M3.1 Flash: Space Performance + Bunny Speed 🚀🐰 Yes, Space Bunny - which has topped global leaderboards with 200T+ tokens - was an earlier version of M3.1 Flash. 💰Redefining the performance economics of agentic AI. M3.1 Flash achieves frontier-level intelligence across key tasks such as Cowork (Automation-Bench: 62%; ALE: 30%), Coding (DeepSWE: 74%) and Visual Reasoning (BabyVision: 91%), at 1/3 the cost of M3 and 3x the speed. API pricing (flat rate): $0.15 / $0.60 per 1M input/output tokens, with cache reads at $0.015 / 1M tokens. Model weights will arrive on Oct 23. API: https://t.co/fHRdSV73Hr M Plan: https://t.co/XfJWSyauda MiniMax Code for desktop: https://t.co/SGmLTI2HQm
,MiniMax (official) (@MiniMax_AI) October 19, 2026
公式カタログには、コンテキストウィンドウ100万トークンとマルチモーダル機能が記載されている。ただし、宣言されたコンテキスト容量は、長大なドキュメントが常に正確に処理されることを保証しない。APIインターフェース経由でモデルを統合する場合。重要なのは各ステップ間で必要な情報を確実に保持することだ。非常に大きなリクエストには不要な指示や矛盾した指示が含まれることがある。受け付け可能であることと、モデルが常に適切な情報を選択できることは別問題だ。
ベンチマークはあくまで限定的なテスト結果だ
言い換えると、MiniMaxはコーディング、コンピュータ操作、セキュリティに関するベンチマーク結果を公開している。同社の発表によると、DeepSWE v1.1で73.7%、OSWorld V2で61.7ポイント、CyberGymで82%を達成している。これらはすべて製品提供元が公開した数値だ。BankerToolBenchでは76.2ポイント、Agents' Last Examでは29.6ポイントという結果も報告されている。各テストは異なるタスクを評価しており、これらを合算して総合的な信頼性の割合を算出することはできない。コーディング問題での優れた結果は、エージェントが文書処理や金融上の権限管理をエラーなく扱えることを単独では証明しない。
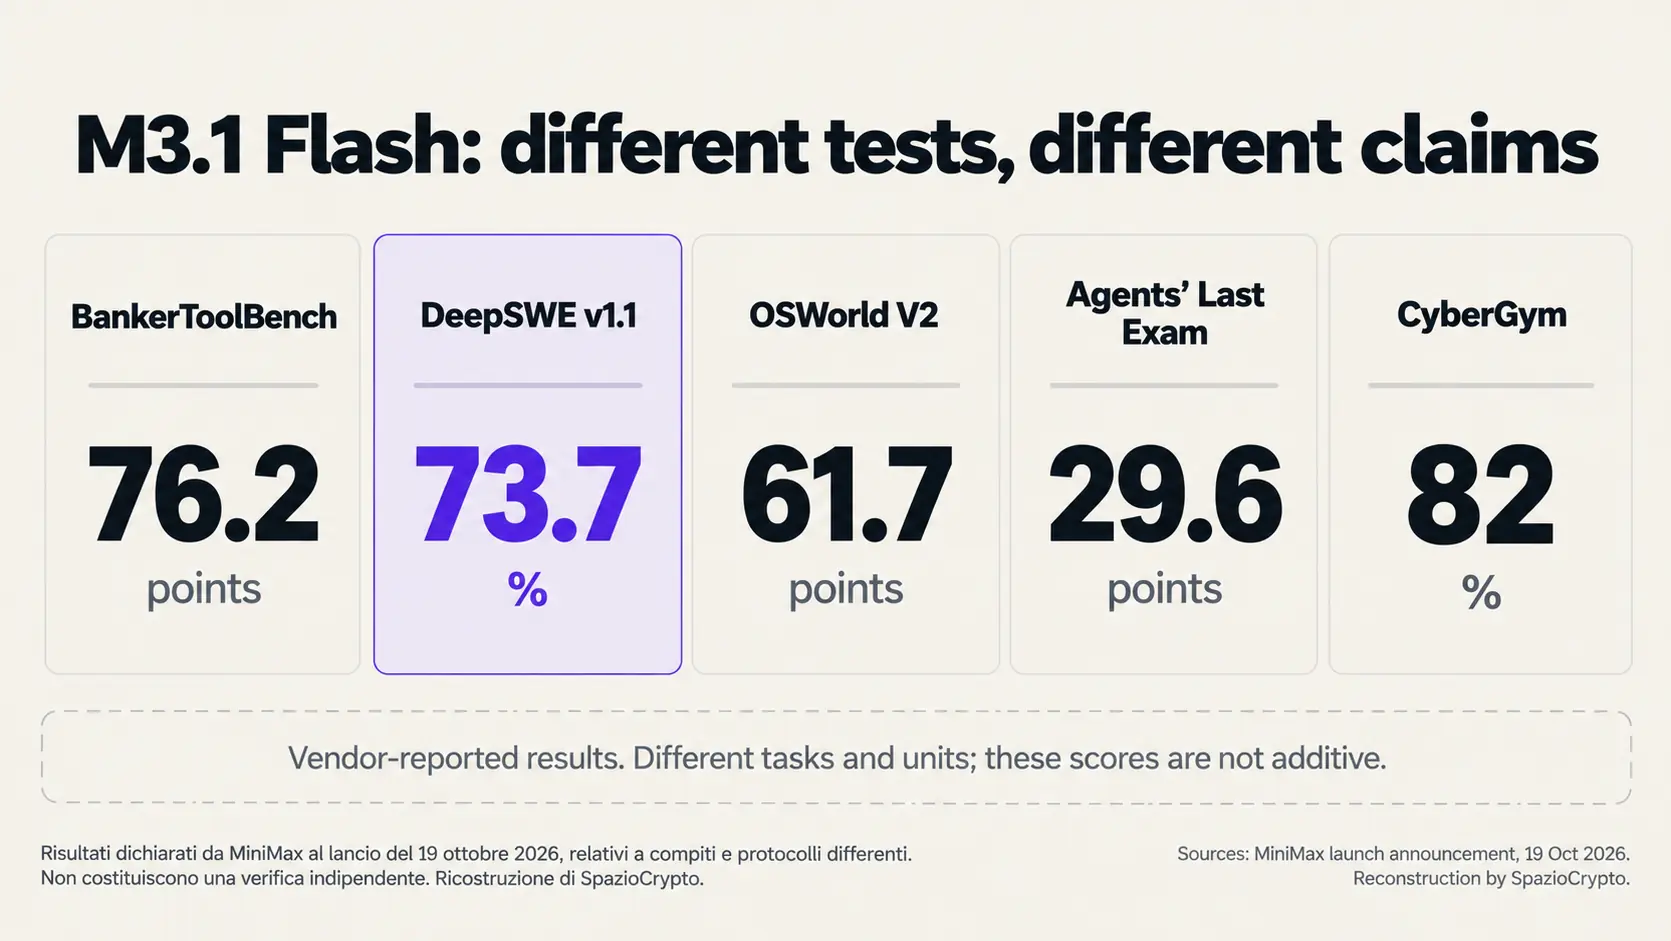
速度の数値にも文脈が必要だ。MiniMaxの公式発表によれば、特定の条件下で毎秒200トークン超、中央値は170超を記録している。これは同社自身のインフラにおける計測値であり、あらゆる処理の所要時間を保証するものではない。毎秒生成トークン数には、API呼び出し間の待機時間や外部サービスの応答、出力確認のための人的確認コストは含まれていない。
この区別はモデル間のベンチマーク比較でも重要になる。数値にはテストのバージョン、使用ツール、推論設定を必ず添えるべきだ。Flashについては、同一の目標と明示されたバジェットによる比較が必要だと筆者は考える。脆弱性発見能力をモデル全体の信頼性の証明として提示すると、観測されたタスクとその他すべての用途が混同される。
Artificial Analysisが別のスイートで外部評価を提供している。同社が2026年10月19日にXへ投稿した内容によると、FlashのIntelligence Indexスコアは42点で、推論は最大設定での評価だ。同インデックスのタスク単価は約0.22ドルと報告されており、M3の約0.51ドルと比較できる。これは開発元以外の第三者が公表した評価であり、筆者による再現検証ではない。そのコストはArtificial Analysisのインデックスが定義するタスクと手法に対するものであって、あらゆる作業の普遍的な価格ではない。
サービスへのアクセスとモデルウェイトの管理は別の段階にある
10月19日のリリースは3つのチャネルを示している。MiniMax API、M Plan、MiniMax Codeだ。公式発表はウェイトの公開を日付未定の「後日」としていたが、MiniMaxの公式LinkedInページへの投稿は10月23日を示している。これはあくまで告知された期限であり、公開済みの事実ではない。利用可能なサービスとダウンロード可能なアーティファクトは、現時点でも別々の段階だ。Space BunnyがモデルのSpace Bunny初期バージョンだという識別はMiniMax自身の声明であり、その名称が独立した評価を構成するわけではない。
MiniMax-M3.1-Flash scores 42 on the Artificial Analysis Intelligence Index, 13 points higher than MiniMax-M3 and less than half the cost per task. It scores level with GLM-5.3-Flash but behind DeepSeek V4.1 Flash 1017
,Artificial Analysis (@ArtificialAnlys) October 19, 2026
MiniMax-M3.1-Flash is @MiniMax_AI's new Flash reasoning… pic.twitter.com/bEelNegMKP
2つのモダリティは異なる検証を可能にする。というのが筆者の見立てだ。ホスト型サービスはインターフェースと応答の挙動を即座に試せる。ウェイトの公開は。添付ライセンスの条件に従って。アーティファクトを保存し他の設定を研究する可能性を開く。公式発表だけでは。そのライセンス内容や必要なハードウェアを説明するには不十分だ。公開前の段階でFlashに完全な自律的利用可能性を帰属させるのは。まだ約束の段階にある工程を先取りすることになる。
有用なコスト計算は完了したタスク単位で行う
支援型コーディングからエージェント型コーディングへの移行において、コストは複数の試行に分散する。エージェントはリポジトリを読み込み、変更を提案し、テストを実行し、確認が失敗すればコードに戻る。これは筆者による実運用の例示であり、Flashで計測した結果ではない。経済的な比較は、使えない結果に終わった実行も含め、作業が承認されるまでのシーケンス全体を計上すべきだ。
独立した評価の価値は、そのシーケンスがどれだけ観測・再現可能かにもかかっている。筆者が提案するのは。結果の採否基準を同一に保ちながら、結果、消費量、繰り返し回数、修正内容を記録することだ。推論レベルを下げると1回の待機は短くなる一方、後続の修正が増える可能性がある。これは選択したワークロードで検証すべき仮説であり、計測なしにモデルへ帰属させる挙動ではない。
MiniMax M3.1 Flash まとめ
- 確認済み: 10月19日のリリース、公開価格表、ホスト型アクセスのドキュメント。
- 未確認: LinkedInで告知された10月23日のウェイト実際のリリース、および各プロセスでのコスト削減効果。
- 引き続き注視すべき点: 同一タスク条件での消費量、必要な修正回数、約束されたアーティファクトの公開状況。
より大きな文脈での解釈
筆者の見立てでは。応用人工知能における競争は、応答単価から「受け入れ可能な成果物」のコストへと軸足を移しつつある。Flashの価格表は計測可能な一要素を下げるが、結果の検証の必要性をなくしはしない。コスト効率の良いモデルが真に有用になるのは、同じ要求水準と実行条件のもとで修正を要するステップも削減できる場合だ。
今後の具体的なシグナルとして注目すべきは、告知されたウェイト公開期限の遵守、明示的な設定による再現可能な比較、代表的なタスクに基づく計測だ。システムが失敗したときに何が起きるかも見届ける必要がある。限界を通知するのか、処理を中断するのか、それともコストをかけ続けるのか。この違いは100万トークン単価では語れないが、信頼できるエージェントの最終コストを左右する。